Opérer
Analytique des Agents
Comprenez comment les bots voient, citent et font référence à vos pages : activité des crawlers, couverture indexée, et les personnes arrivées depuis une réponse.
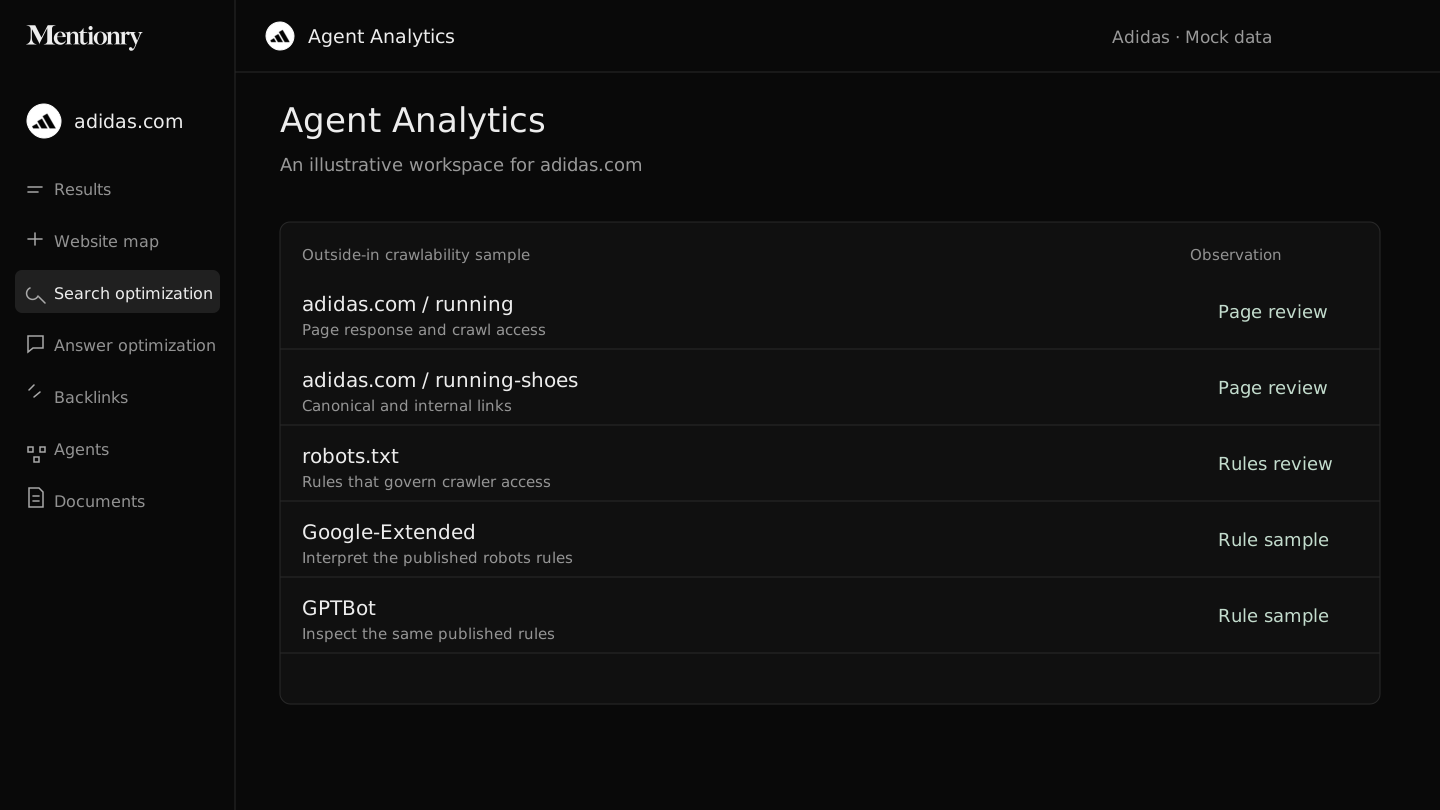
Une vérification robots.txt pour crawler IA est un audit technique pour voir quels bots IA, comme le GPTBot d'OpenAI ou Google-Extended, sont autorisés à accéder et lire le contenu de votre site. C'est important car ces bots sont le moyen par lequel les moteurs de réponse comme ChatGPT et Google AI Overviews découvrent et citent des pages. La fonctionnalité Agent Analytics de Mentionry vous montre précisément quels crawlers IA sont autorisés par votre fichier robots.txt, met en lumière les problèmes de crawlabilité, et suit quelles pages sont référencées dans les réponses générées par l'IA, vous aidant à prouver l'impact sur le trafic piloté par l'IA.
Comprenez et contrôlez votre présence IA
Visibilité pour les crawlers IA
Voyez quels robots IA sont autorisés sur votre contenu : GPTBot, ClaudeBot, PerplexityBot, Google-Extended et les autres, par rapport à vos règles robots.
Explorabilité
Temps de réponse, rendu, ressources bloquées, la page telle qu'elle est récupérée sans JavaScript. Les problèmes qui rendent une page illisible pour un robot.
Suivi de la performance du contenu
Les pages que les modèles d'IA préfèrent, les liens cassés sur votre site, et le texte d'ancrage pointant vers vous sur le web.
Ce qui n'est pas encore là
- L'ingestion des logs serveur, qui montre quels bots ont réellement visité et à quelle fréquence, n'est pas implémentée. Tout ce qui est affiché sur cet écran est lu depuis l'extérieur.
- Pour comparer avec d'autres sites, il nous faut une population que nous n'avons pas encore. Nous préférons ne rien afficher plutôt qu'un percentile calculé sur un échantillon d'un seul site.
Où cela se trouve dans la plateforme
Ouvrez /dashboard/crawlers pour la disponibilité actuelle et les exigences de données. Les limites de collection et d'espace de travail dépendent de votre plan.
Qu'est-ce qu'un contrôle robots.txt pour les crawlers d'IA
Lorsqu'un utilisateur pose une question à un moteur de réponse, ce dernier doit trouver des informations pour construire sa réponse. Il envoie des robots spécialisés, appelés crawlers d'IA, pour lire les pages web. Parmi eux, on trouve GPTBot pour ChatGPT, ClaudeBot pour Claude, PerplexityBot et Google-Extended pour les modèles d'IA de Google.
Le fichier robots.txt de votre site web est le premier gardien. Il indique à ces robots quelles parties de votre site ils sont autorisés à visiter. Un contrôle robots.txt pour les crawlers d'IA est le processus d'audit de ce fichier pour voir quels robots vous accueillez et lesquels vous bloquez. C'est une pièce fondamentale du SEO technique pour la recherche IA. Si vos pages clés sont bloquées, elles ne peuvent pas être lues et n'apparaîtront pas comme citations dans les réponses d'IA.
Pourquoi c'est crucial pour la visibilité dans la recherche IA
Le SEO traditionnel visait à se classer dans une liste de dix liens bleus. La recherche IA, ou l'optimisation pour les moteurs de réponse, est différente. L'objectif est d'être l'une des rares sources citées dans un paragraphe unique généré. Les moteurs sont sélectifs, et ils ne citent que les pages que leurs robots d'indexation ont été autorisés à lire.
Autoriser les robots d'indexation IA est la première étape, non négociable. Si GPTBot ne peut pas accéder à votre blog, ChatGPT ne peut pas apprendre de celui-ci. Si Google-Extended est bloqué, votre contenu est invisible pour les Google AI Overviews. Cette vérification ne concerne pas le volume de trafic, mais l'éligibilité. Vous vérifiez votre ticket d'entrée dans l'arène où les réponses IA sont rédigées.
Comment fonctionne l'analyse des agents dans Mentionry
L'analyse des agents, accessible via /dashboard/crawlers, vous fournit un rapport technique axé sur la recherche IA. Elle fonctionne en analysant votre site de l'extérieur, exactement comme le ferait un robot d'IA. Elle vérifie votre fichier robots.txt et tout fichier llms.txt que vous avez configuré, puis rapporte ses conclusions.
L'écran est organisé en trois zones. La visibilité pour les robots d'IA affiche une liste de robots connus, comme GPTBot et ClaudeBot, et indique clairement si vos règles actuelles les autorisent ou les bloquent. L'explorabilité exécute une récupération simulée de vos pages, en rapportant les temps de réponse, les ressources bloquées et le rendu de la page sans JavaScript, en mettant en évidence les problèmes qui pourraient rendre votre contenu illisible. Le suivi des performances du contenu montre quelles pages de votre site sont indexées par les services pertinents pour l'IA et collecte des données sur le texte d'ancrage pointant vers votre site depuis le web entier.
Comment l'intégrer dans votre flux de travail hebdomadaire
Pour un marketeur, il s'agit d'un outil de diagnostic et de suivi. Un flux de travail typique commence par un audit. Ouvrez Agent Analytics et examinez la liste de visibilité des crawlers IA. Pour un site de lancement d'un nouveau produit, vous vérifiez que tous les principaux bots sont autorisés sur vos pages de destination et de documentation clés.
Ensuite, utilisez le rapport de crawlabilité. Filtrez sur une page haute priorité, comme la description de votre service phare. Recherchez les avertissements concernant les fichiers CSS ou JavaScript bloqués qui pourraient empêcher le rendu correct de la page pour un bot. Corrigez ces problèmes dans votre code. Enfin, vérifiez les performances du contenu chaque semaine. Recherchez les nouvelles pages qui sont entrées dans la liste 'indexée', indiquant qu'elles sont désormais récupérées par les services d'IA, et examinez le rapport sur le texte d'ancrage pour voir comment d'autres sites décrivent votre marque lorsqu'ils créent un lien vers vous.
Comment interpréter les chiffres et éviter les pièges
Un statut 'Autorisé' en vert pour GPTBot signifie que votre fichier robots.txt lui donne l'accès. Cela ne signifie pas que GPTBot a visité votre site, ni que votre contenu sera cité. Cela signifie simplement que la porte est ouverte. Un temps de réponse lent dans le rapport de crawlabilité est un problème direct, car les robots ont des limites de temps et peuvent abandonner les pages trop lentes.
La métrique 'Couverture indexée' montre quelles pages les systèmes connaissent. Une augmentation ici est un signal positif d'une visibilité IA croissante. Le rapport sur le texte d'ancrage est utile pour comprendre la perception de la marque. Un changement de 'logiciel' à 'plateforme de marketing IA' dans la façon dont les autres sites vous lient reflète une évolution du récit de marché. N'oubliez pas que ce sont des indicateurs avancés, pas des promesses de trafic ou de citations.
Ce que Agent Analytics ne fait pas encore
Il est important d'énoncer clairement les limites. Agent Analytics lit votre site depuis l'internet public. Il n'ingère pas vos logs serveur. L'ingestion des logs serveur vous montrerait exactement quels bots ont visité, à quelle fréquence et ce qu'ils ont récupéré. Ce niveau de détail n'est pas implémenté.
La fonctionnalité ne peut pas non plus comparer votre site à d'autres. Pour affirmer que votre crawlabilité se situe au 80e centile, il faut une large population de sites comparables à mesurer. Nous ne disposons pas de cette population, et nous préférons ne rien afficher plutôt que de fournir un centile trompeur basé sur un échantillon unique.
Plans et accès
Gratuit inclut un instantané enregistré de 3 questions et 3 pages maximum. Sans carte. Sans expiration. Lite $29/mois · Growth $99/mois · Agency $249/mois (USD).
Growth : 50 questions · 40 crédits de brouillon et d'agent partagés/mois · $99/mois (USD).
Questions
Le trafic bot en direct nécessite vos logs serveur ; l'ingestion des logs est sur la liste des intégrations. Ce que vous pouvez voir aujourd'hui, c'est ce que chaque bot est autorisé à lire et comment vos pages s'affichent pour lui.
Faites mentionner votre marque par les moteurs de réponse
Commencez avec un instantané gratuit. Les plans payants ajoutent une recherche planifiée éligible dans les limites indiquées sur Tarification. Les données Store et Google nécessitent votre autorisation.